Google:s två TPU:er gör uppdelningen av träning och slutledning explicit
TPU 8t och TPU 8i pekar mot en marknad där den bästa arkitekturen i allt högre grad beror på jobbet som utförs.
En generation, två prioriteringar
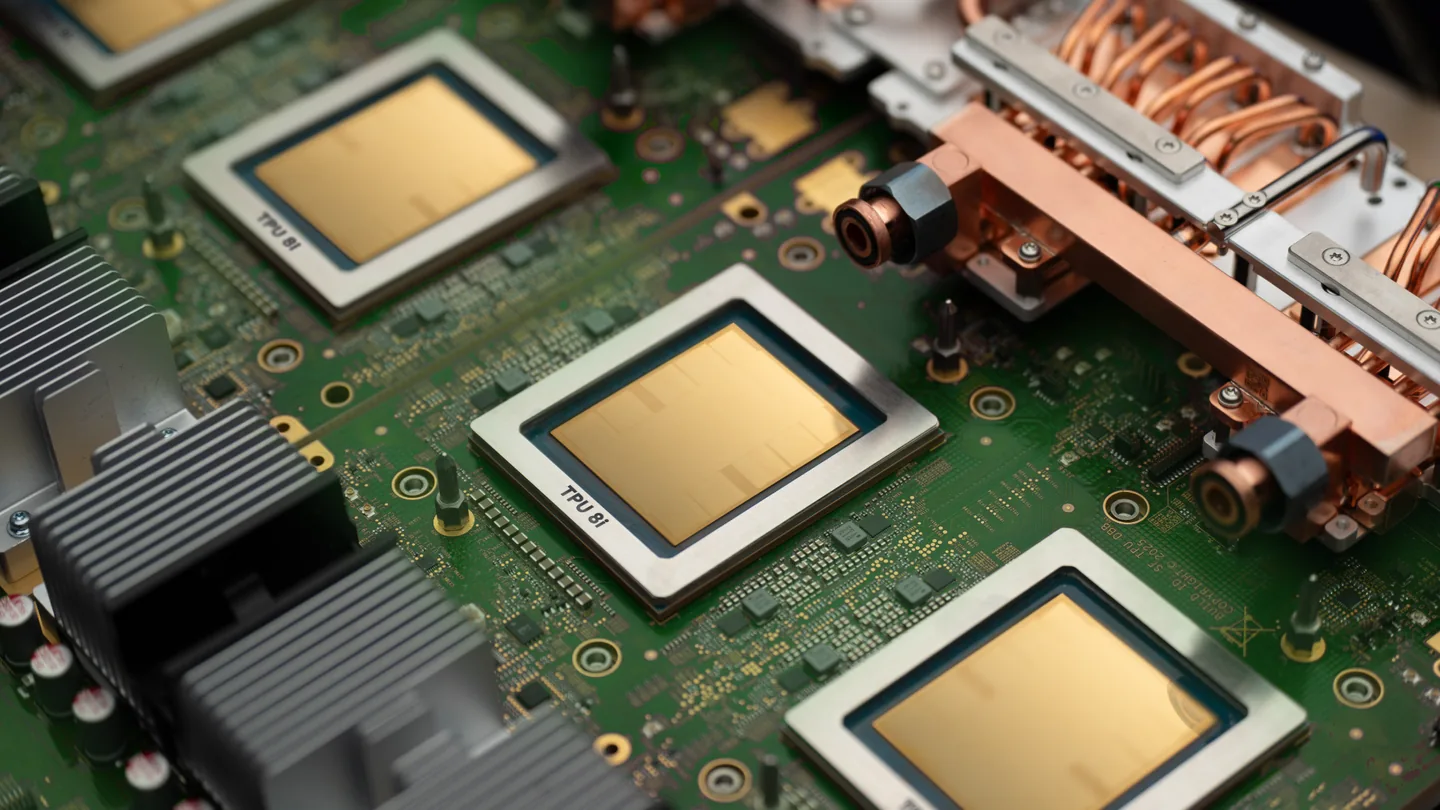
På Cloud Next i april 2026 introducerade Google TPU 8t för träning och TPU 8i för slutledning. Den splittringen gör en bredare branschutveckling synlig: att bygga en modell och betjäna den är olika infrastrukturproblem, även när de tillhör samma produkt. Tillkännagivandet är en plattformsintroduktion, inte ett bevis på att varje konfiguration är allmänt tillgänglig för varje kund idag. Google: TPU 8t och TPU 8i ↗
Utbildning frågar vanligtvis hur snabbt en definierad körning kan avslutas inom en resursbudget. En liveinferenstjänst måste också bry sig om svarstider, oförutsägbar efterfrågan och kostnaden för att leverera ett acceptabelt svar. Det finns undantag och överlappningar, men inköpsfrågorna är tillräckligt olika för att förtjäna separat utvärdering.
Genomströmning är inte hela tjänsten
Föreställ dig två slutledningsinstallationer med liknande maximal effekt. Man når den utgången endast genom att tillåta förfrågningar att vänta i en stor sats. Den andra hanterar färre samtidiga förfrågningar men svarar inom programmets latenstidsmål. Vilket som är bättre beror på om arbetet är ett övernattningsjobb eller en interaktiv tjänst.
Det exemplet förklarar varför ett imponerande acceleratorriktmärke inte är en komplett tjänstjämförelse. Ingångs- och utmatningslängder, samtidighet, modellprecision och acceptabel svarstid måste stämma överens. Annars kan den uppenbara prisfördelen bero på att du levererar en annan upplevelse.
En molnarkitektur förändrar köpbeslutet
TPU:er är också en påminnelse om att några viktiga alternativ till GPUs erhålls som molntjänster. Att jämföra dem med en ägd server kräver mer än att konvertera ett timpris till ett inköpspris för hårdvara.
Inkludera ingenjörsarbete, villkor för engagerad användning, lagring, dataförflyttning och kostnaden för att behålla ett exitalternativ. Fastställ om de avsedda ramverken och modellimplementeringarna stöds. Kontrollera vad som händer när efterfrågan överstiger den kapacitet du reserverat, eller faller under den.
Ett ägt system har sina egna begränsningar: kapital bundet i utrustning, installationsarbete och en begränsad mängd kapacitet. En rättvis jämförelse anger dessa skillnader uttryckligen istället för att anta att antingen ägande eller hyra automatiskt är ekonomiskt.
Fördela arbetsbelastningen innan du väljer plattform
Ett företag behöver inte träna och betjäna på identisk infrastruktur. Det krävs en pålitlig process för att flytta modeller mellan miljöer och kontrollera att kvalitet och prestanda förblir acceptabel.
Det praktiska svaret på Googles tvåplattformsmetod är att skriva två uppsättningar krav. Man bör beskriva utveckling och träning; den andra ska beskriva produktionstjänsten. Om dessa krav leder till annan hårdvara eller leverantörer kan det vara ett medvetet arkitekturval. Den användbara frågan är vad hela arbetsflödet kostar och hur tillförlitligt det fungerar.
Källor & vidare läsning
Primära källor för den rapporterade utvecklingen och tekniska sammanhang. Analyser och slutsatser är våra egna; länkade specifikationer och dokumentation kan ändras.
- Google: TPU 8t och TPU 8i ↗Publicerad 22 april 2026
Källor kontrollerade 29 september 2026.