Le due TPU di Google rendono esplicita la suddivisione tra addestramento e inferenza
TPU 8t e TPU 8i indicano un mercato in cui la migliore architettura dipende sempre più dal lavoro svolto.
Una generazione, due priorità
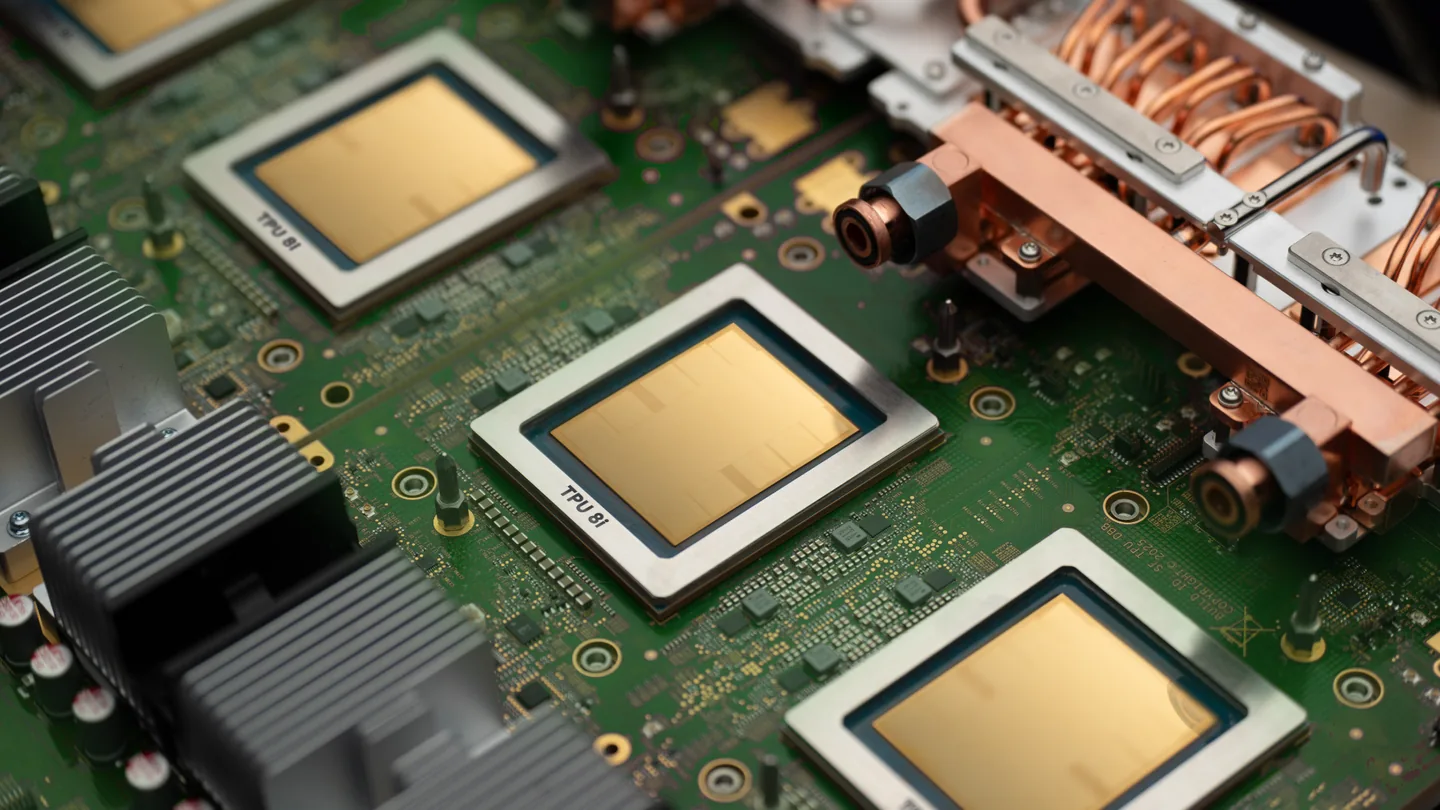
Al Cloud Next dell'aprile 2026, Google ha presentato TPU 8t per l'addestramento e TPU 8i per l'inferenza. Questa divisione rende visibile uno sviluppo più ampio del settore: costruire un modello e servirlo sono problemi infrastrutturali diversi, anche quando appartengono allo stesso prodotto. L'annuncio è un'introduzione alla piattaforma, non una prova che ogni configurazione sia generalmente disponibile per ogni cliente oggi. Google: TPU 8t e TPU 8i ↗
La formazione in genere chiede quanto velocemente un'esecuzione definita può terminare entro un budget di risorse. Un servizio di inferenza dal vivo deve anche preoccuparsi dei tempi di risposta, della domanda imprevedibile e del costo per fornire una risposta accettabile. Ci sono eccezioni e sovrapposizioni, ma le questioni di acquisto sono abbastanza diverse da meritare una valutazione separata.
Il throughput non è l'intero servizio
Immagina due distribuzioni di inferenza con un output massimo simile. Si raggiunge quell'output solo consentendo alle richieste di attendere in un batch di grandi dimensioni. L'altro gestisce meno richieste simultanee ma risponde entro il target di latenza dell'applicazione. Quale sia la soluzione migliore dipende dal fatto che il lavoro sia un lavoro notturno o un servizio interattivo.
Questo esempio spiega perché un benchmark impressionante di un acceleratore non è un confronto completo dei servizi. Le lunghezze di input e output, la concorrenza, la precisione del modello e il tempo di risposta accettabile devono tutti corrispondere. Altrimenti, l’apparente vantaggio di prezzo potrebbe dipendere dall’offerta di un’esperienza diversa.
Un'architettura cloud cambia la decisione di acquisto
Le TPU ricordano anche che alcune importanti alternative a GPUs si ottengono come servizi cloud. Confrontarli con un server di proprietà richiede molto più che convertire una tariffa oraria in un prezzo di acquisto dell'hardware.
Includere il lavoro di ingegneria, i termini di impegno di utilizzo, l'archiviazione, lo spostamento dei dati e il costo per il mantenimento di un'opzione di uscita. Stabilire se i framework previsti e le implementazioni del modello sono supportati. Controlla cosa succede quando la domanda supera la capacità prenotata o scende al di sotto di essa.
Un sistema di proprietà ha i propri vincoli: capitale vincolato in attrezzature, lavori di installazione e una quantità limitata di capacità. Un confronto equo afferma esplicitamente queste differenze invece di presupporre che la proprietà o l'affitto siano automaticamente economici.
Dividere il carico di lavoro prima di scegliere la piattaforma
Un'azienda non deve formarsi e servire su un'infrastruttura identica. Ha bisogno di un processo affidabile per spostare i modelli tra ambienti e verificare che la qualità e le prestazioni rimangano accettabili.
La risposta pratica all'approccio a due piattaforme di Google è scrivere due serie di requisiti. Si dovrebbero descrivere lo sviluppo e la formazione; l'altro dovrebbe descrivere il servizio di produzione. Se tali requisiti portano a hardware o fornitori diversi, può trattarsi di una scelta architetturale deliberata. La domanda utile è quanto costa il flusso di lavoro completo e quanto è affidabile.
Fonti e approfondimenti
Fonti primarie per gli sviluppi riportati e il contesto tecnico. L'analisi e le conclusioni sono nostre; le specifiche e la documentazione collegate possono cambiare.
- Google: TPU 8t e TPU 8i ↗Pubblicato il 22 aprile 2026
Fonti controllate il 29 settembre 2026.