Die beiden TPUs von Google machen die Aufteilung zwischen Training und Inferenz explizit
TPU 8t und TPU 8i weisen auf einen Markt hin, in dem die beste Architektur zunehmend von der geleisteten Arbeit abhängt.
Eine Generation, zwei Prioritäten
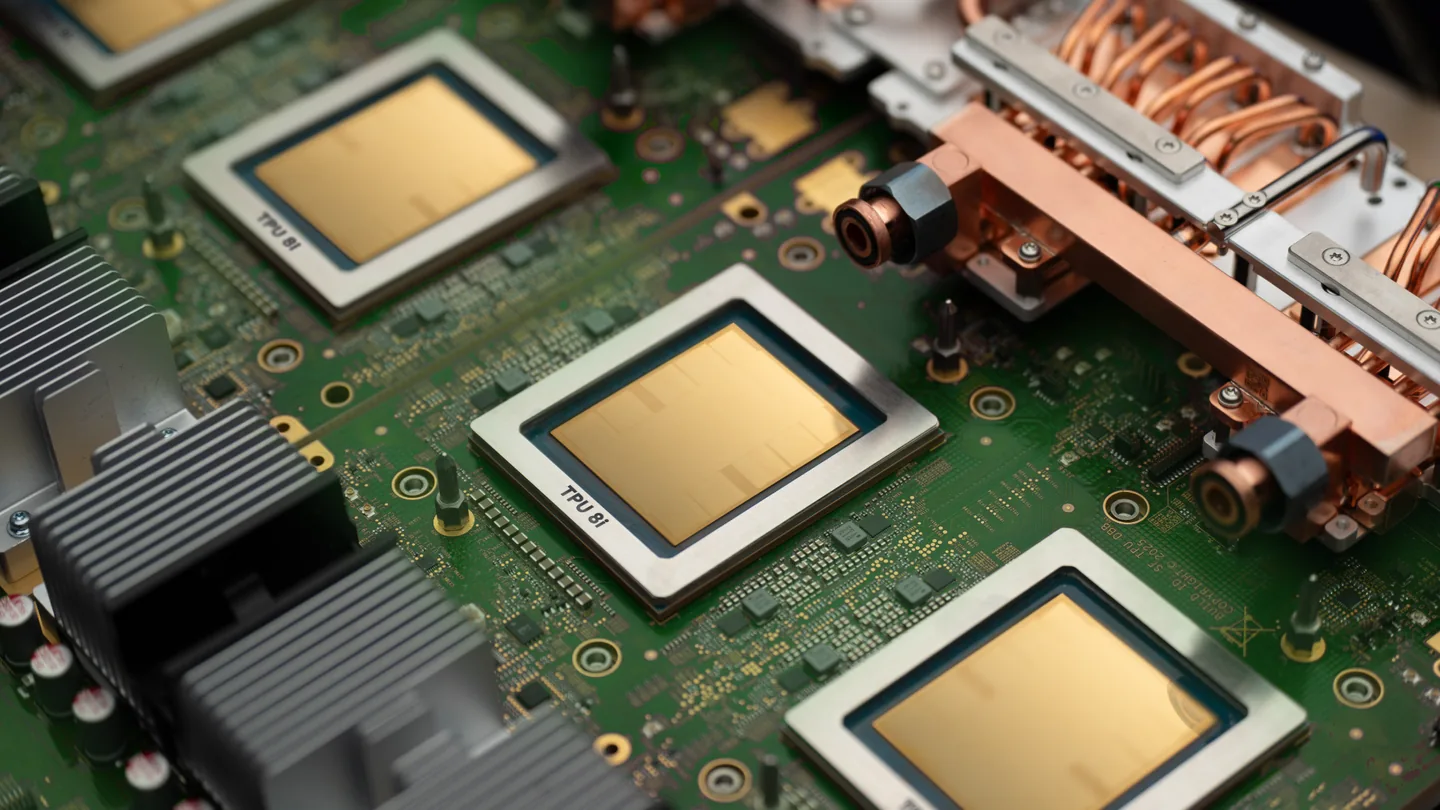
Auf der Cloud Next im April 2026 stellte Google TPU 8t für das Training und TPU 8i für Inferenz vor. Diese Spaltung macht eine breitere Branchenentwicklung sichtbar: Der Aufbau eines Modells und die Bereitstellung desselben sind unterschiedliche Infrastrukturprobleme, selbst wenn sie zum selben Produkt gehören. Bei der Ankündigung handelt es sich um eine Plattformeinführung und nicht um einen Beweis dafür, dass jede Konfiguration heute allgemein für jeden Kunden verfügbar ist. Google: TPU 8t und TPU 8i ↗
Beim Training wird typischerweise gefragt, wie schnell ein definierter Lauf innerhalb eines Ressourcenbudgets abgeschlossen werden kann. Ein Live-Inferenzdienst muss sich auch um Antwortzeiten, unvorhersehbare Nachfrage und die Kosten für die Bereitstellung einer akzeptablen Antwort kümmern. Es gibt Ausnahmen und Überschneidungen, aber die Kauffragen sind so unterschiedlich, dass sie eine gesonderte Bewertung verdienen.
Der Durchsatz ist nicht der gesamte Dienst
Stellen Sie sich zwei Inferenzbereitstellungen mit ähnlicher Maximalleistung vor. Diesen Output erreicht man nur, wenn man Anfragen in großen Mengen warten lässt. Der andere verarbeitet weniger gleichzeitige Anfragen, antwortet jedoch innerhalb des Latenzziels der Anwendung. Was besser ist, hängt davon ab, ob es sich bei der Arbeit um einen Nachtjob oder eine interaktive Dienstleistung handelt.
Dieses Beispiel erklärt, warum ein beeindruckender Beschleuniger-Benchmark kein vollständiger Servicevergleich ist. Eingabe- und Ausgabelängen, Parallelität, Modellgenauigkeit und akzeptable Antwortzeit müssen alle übereinstimmen. Andernfalls kann der scheinbare Preisvorteil davon abhängen, dass ein anderes Erlebnis geboten wird.
Eine Cloud-Architektur verändert die Kaufentscheidung
TPUs erinnern auch daran, dass einige wichtige Alternativen zu GPUs als Cloud-Dienste bezogen werden. Der Vergleich mit einem eigenen Server erfordert mehr als die Umrechnung eines Stundensatzes in einen Hardware-Kaufpreis.
Beinhaltet technische Arbeiten, Bedingungen für die verbindliche Nutzung, Speicherung, Datenverschiebung und die Kosten für die Beibehaltung einer Ausstiegsoption. Stellen Sie fest, ob die vorgesehenen Frameworks und Modellimplementierungen unterstützt werden. Prüfen Sie, was passiert, wenn die Nachfrage die von Ihnen reservierte Kapazität übersteigt oder unterschreitet.
Ein eigenes System hat seine eigenen Einschränkungen: gebundenes Kapital in Ausrüstung, Installationsarbeiten und eine begrenzte Kapazität. Bei einem fairen Vergleich werden diese Unterschiede ausdrücklich hervorgehoben, anstatt davon auszugehen, dass Eigentum oder Miete automatisch wirtschaftlich sind.
Teilen Sie die Arbeitslast auf, bevor Sie die Plattform auswählen
Ein Unternehmen muss nicht auf der gleichen Infrastruktur trainieren und arbeiten. Es braucht einen zuverlässigen Prozess zum Verschieben von Modellen zwischen Umgebungen und zum Überprüfen, dass Qualität und Leistung akzeptabel bleiben.
Die praktische Antwort auf den Zwei-Plattform-Ansatz von Google besteht darin, zwei Sätze von Anforderungen zu schreiben. Man sollte Entwicklung und Ausbildung beschreiben; der andere sollte die Produktionsdienstleistung beschreiben. Wenn diese Anforderungen zu unterschiedlicher Hardware oder unterschiedlichen Anbietern führen, kann dies eine bewusste Entscheidung für die Architektur sein. Die sinnvolle Frage ist, was der komplette Workflow kostet und wie zuverlässig er läuft.
Quellen & weiterführende Literatur
Primärquellen für die gemeldeten Entwicklungen und den technischen Kontext. Analysen und Schlussfolgerungen sind unsere eigenen; verlinkte Spezifikationen und Dokumentationen können sich ändern.
- Google: TPU 8t und TPU 8i ↗Veröffentlicht am 22. April 2026
Quellen überprüft am 29. September 2026.