Las dos TPU de Google hacen explícita la división entre entrenamiento e inferencia
TPU 8t y TPU 8i apuntan a un mercado donde la mejor arquitectura depende cada vez más del trabajo que se realiza.
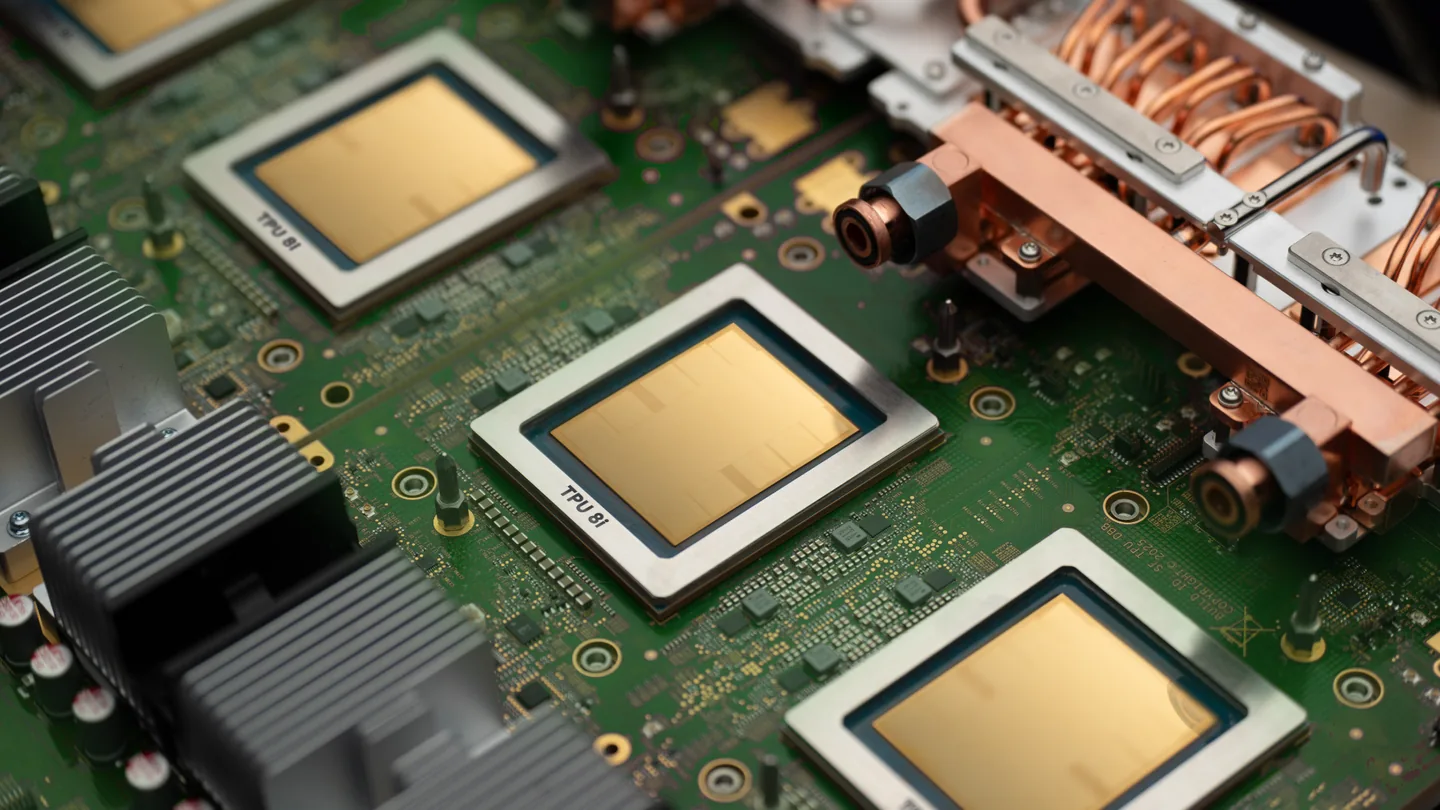
Una generación, dos prioridades
En Cloud Next en abril de 2026, Google presentó TPU 8t para entrenamiento y TPU 8i para inferencia. Esa división hace visible un desarrollo industrial más amplio: construir un modelo y servirlo son problemas de infraestructura diferentes, incluso cuando pertenecen al mismo producto. El anuncio es una introducción a la plataforma, no una prueba de que todas las configuraciones estén generalmente disponibles para todos los clientes en la actualidad. Google: TPU 8t y TPU 8i ↗
La entrenamiento generalmente pregunta qué tan rápido puede finalizar una ejecución definida dentro de un presupuesto de recursos. Un servicio de inferencia en vivo también debe preocuparse por los tiempos de respuesta, la demanda impredecible y el costo de brindar una respuesta aceptable. Hay excepciones y superposiciones, pero las preguntas sobre compras son lo suficientemente diferentes como para merecer una evaluación separada.
El rendimiento no es todo el servicio
Imagine dos implementaciones de inferencia con un resultado máximo similar. Se alcanza ese resultado solo permitiendo que las solicitudes esperen en un lote grande. El otro maneja menos solicitudes simultáneas pero responde dentro del objetivo de latencia de la aplicación. Cuál es mejor depende de si el trabajo es un trabajo nocturno o un servicio interactivo.
Ese ejemplo explica por qué una prueba comparativa de acelerador impresionante no es una comparación de servicios completa. Las longitudes de entrada y salida, la simultaneidad, la precisión del modelo y el tiempo de respuesta aceptable deben coincidir. De lo contrario, la aparente ventaja de precio puede depender de ofrecer una experiencia diferente.
Una arquitectura en la nube cambia la decisión de compra
Los TPU también son un recordatorio de que algunas alternativas importantes a GPUs se obtienen como servicios en la nube. Compararlos con un servidor propio requiere más que convertir una tarifa por hora en un precio de compra de hardware.
Incluya el trabajo de ingeniería, los términos de uso comprometido, el almacenamiento, el movimiento de datos y el costo de retener una opción de salida. Establecer si los marcos previstos y las implementaciones de modelos son compatibles. Comprueba qué ocurre cuando la demanda supera la capacidad reservada o cae por debajo de ella.
Un sistema propio tiene sus propias limitaciones: capital invertido en equipos, trabajos de instalación y una cantidad finita de capacidad. Una comparación justa establece explícitamente estas diferencias en lugar de asumir que la propiedad o el alquiler son automáticamente económicos.
Dividir la carga de trabajo antes de elegir la plataforma
Una empresa no tiene que capacitarse y prestar servicios en una infraestructura idéntica. Necesita un proceso confiable para mover modelos entre entornos y verificar que la calidad y el rendimiento sigan siendo aceptables.
La respuesta práctica al enfoque de dos plataformas de Google es escribir dos conjuntos de requisitos. Se debería describir el desarrollo y la formación; el otro debe describir el servicio de producción. Si esos requisitos conducen a diferentes hardware o proveedores, esa puede ser una elección de arquitectura deliberada. La pregunta útil es cuánto cuesta el flujo de trabajo completo y con qué fiabilidad se ejecuta.
Fuentes y lecturas adicionales
Fuentes primarias de los desarrollos reportados y contexto técnico. Los análisis y conclusiones son nuestros; Las especificaciones y la documentación vinculadas pueden cambiar.
- Google: TPU 8t y TPU 8i ↗Publicado el 22 de abril de 2026
Fuentes consultadas el 29 de septiembre de 2026.