De twee TPU's van Google maken de splitsing tussen training en gevolgtrekking expliciet
TPU 8t en TPU 8i wijzen op een markt waar de beste architectuur steeds meer afhangt van de klus die wordt geklaard.
Eén generatie, twee prioriteiten
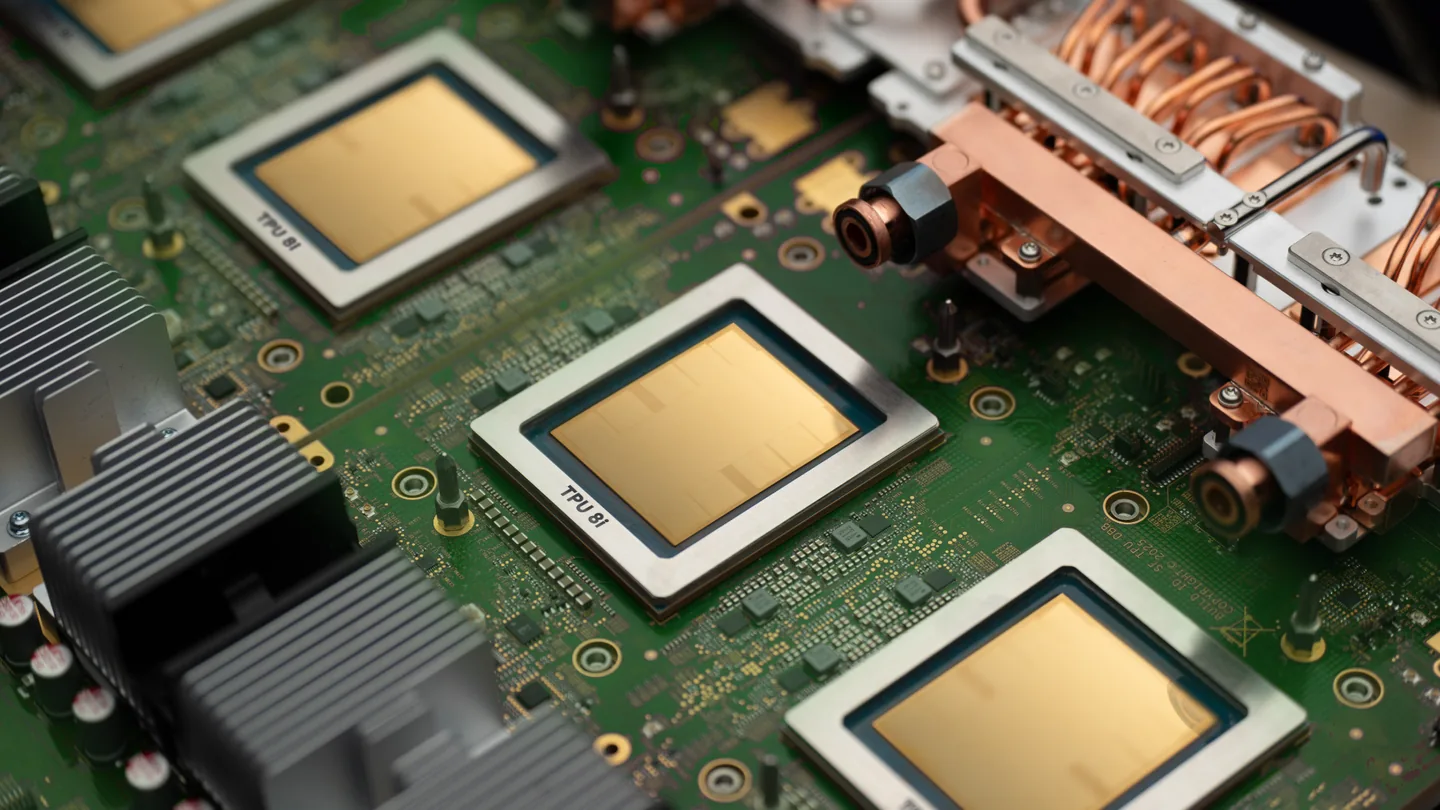
Tijdens Cloud Next in april 2026 introduceerde Google TPU 8t voor training en TPU 8i voor gevolgtrekking. Die splitsing maakt een bredere ontwikkeling van de sector zichtbaar: het bouwen van een model en het bedienen ervan zijn verschillende infrastructuurproblemen, zelfs als ze tot hetzelfde product behoren. De aankondiging is een platformintroductie en geen bewijs dat elke configuratie tegenwoordig algemeen beschikbaar is voor elke klant. Google: TPU 8t en TPU 8i ↗
Bij training wordt doorgaans gevraagd hoe snel een gedefinieerde run kan worden voltooid binnen een resourcebudget. Een live-inferentiedienst moet ook rekening houden met responstijden, onvoorspelbare vraag en de kosten van het aanbieden van een acceptabel antwoord. Er zijn uitzonderingen en overlappingen, maar de inkoopvragen zijn verschillend genoeg om een aparte beoordeling te verdienen.
De doorvoer is niet de hele service
Stel je twee inferentie-implementaties voor met een vergelijkbare maximale output. Die output bereik je alleen door aanvragen in een grote batch te laten wachten. De andere verwerkt minder gelijktijdige verzoeken, maar reageert binnen de latentiedoelstelling van de applicatie. Wat beter is, hangt ervan af of het werk een nachtelijke klus is of een interactieve dienst.
Dat voorbeeld verklaart waarom een indrukwekkende acceleratorbenchmark geen volledige servicevergelijking is. Invoer- en uitvoerlengtes, gelijktijdigheid, modelprecisie en acceptabele responstijd moeten allemaal op elkaar aansluiten. Anders kan het schijnbare prijsvoordeel afhangen van het leveren van een andere ervaring.
Een cloudarchitectuur verandert de aankoopbeslissing
TPU's herinneren er ook aan dat enkele belangrijke alternatieven voor GPUs als cloudservices worden verkregen. Om ze te vergelijken met een eigen server is meer nodig dan het omzetten van een uurtarief in een hardwareaankoopprijs.
Inclusief engineeringwerkzaamheden, voorwaarden voor vastgelegd gebruik, opslag, gegevensverplaatsing en de kosten voor het behouden van een exit-optie. Stel vast of de beoogde raamwerken en modelimplementaties worden ondersteund. Bekijk wat er gebeurt als de vraag de door u gereserveerde capaciteit overschrijdt, of eronder zakt.
Een systeem in eigendom heeft zijn eigen beperkingen: kapitaal dat vastzit aan apparatuur, installatiewerk en een eindige hoeveelheid capaciteit. Bij een eerlijke vergelijking worden deze verschillen expliciet vermeld, in plaats van aan te nemen dat eigendom of verhuur automatisch economisch is.
Verdeel de werklast voordat u het platform kiest
Een bedrijf hoeft niet te trainen en te werken op een identieke infrastructuur. Er is wel een betrouwbaar proces nodig om modellen tussen omgevingen te verplaatsen en te controleren of de kwaliteit en prestaties acceptabel blijven.
Het praktische antwoord op de tweeplatformbenadering van Google is het schrijven van twee reeksen vereisten. Men zou ontwikkeling en training moeten beschrijven; de andere moet de productiedienst beschrijven. Als die eisen tot andere hardware of aanbieders leiden, kan dat een bewuste architectuurkeuze zijn. De nuttige vraag is wat de volledige workflow kost en hoe betrouwbaar deze verloopt.
Bronnen en verder lezen
Primaire bronnen voor de gerapporteerde ontwikkelingen en technische context. Analyse en conclusies zijn van onszelf; gekoppelde specificaties en documentatie kunnen veranderen.
- Google: TPU 8t en TPU 8i ↗Gepubliceerd op 22 april 2026
Bronnen gecontroleerd op 29 september 2026.