As duas TPUs de Google tornam explícita a divisão treinamento-inferência
TPU 8t e TPU 8i apontam para um mercado onde a melhor arquitetura depende cada vez mais do trabalho que está sendo realizado.
Uma geração, duas prioridades
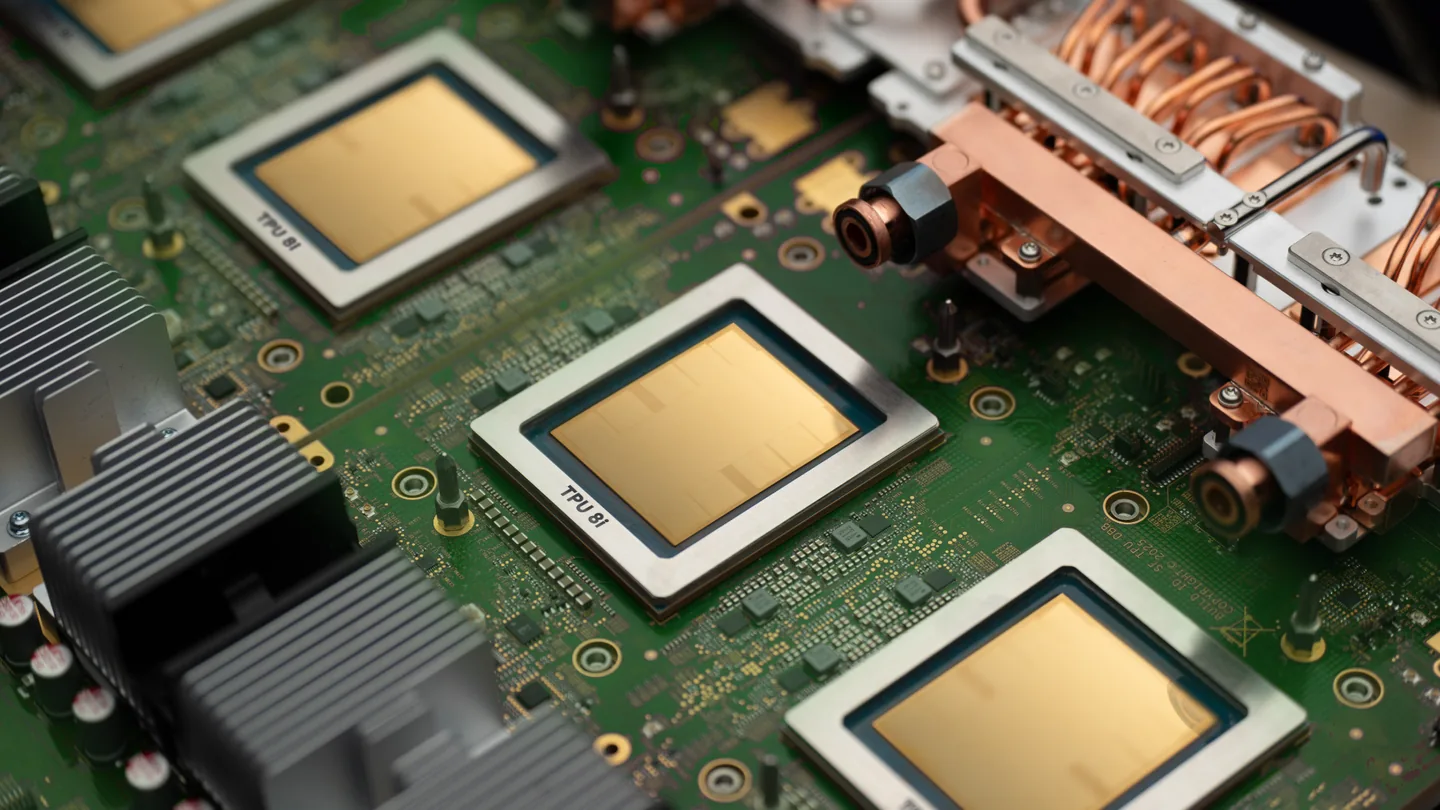
No Cloud Next em abril de 2026, Google introduziu a TPU 8t para treinamento e a TPU 8i para inferência. Essa divisão torna visível um desenvolvimento mais amplo da indústria: construir um modelo e servi-lo são problemas de infraestrutura diferentes, mesmo quando pertencem ao mesmo produto. O anúncio é uma introdução à plataforma, e não uma evidência de que todas as configurações estejam disponíveis para todos os clientes atualmente. Google: TPU 8t e TPU 8i ↗
O treinamento normalmente pergunta com que rapidez uma execução definida pode ser concluída dentro de um orçamento de recursos. Um serviço de inferência ao vivo também deve se preocupar com os tempos de resposta, a demanda imprevisível e o custo de fornecer uma resposta aceitável. Existem exceções e sobreposições, mas as questões de compra são suficientemente diferentes para merecer uma avaliação separada.
A taxa de transferência não é todo o serviço
Imagine duas implantações de inferência com saída máxima semelhante. Atingimos essa saída apenas permitindo que as solicitações esperem em um lote grande. O outro lida com menos solicitações simultâneas, mas responde dentro da meta de latência do aplicativo. O que é melhor depende se o trabalho é noturno ou um serviço interativo.
Esse exemplo explica por que um benchmark de acelerador impressionante não é uma comparação completa de serviços. Comprimentos de entrada e saída, simultaneidade, precisão do modelo e tempo de resposta aceitável precisam ser iguais. Caso contrário, a aparente vantagem de preço pode depender da entrega de uma experiência diferente.
Uma arquitetura em nuvem muda a decisão de compra
As TPUs também são um lembrete de que algumas alternativas importantes para GPUs são obtidas como serviços em nuvem. Compará-los com um servidor próprio exige mais do que converter uma taxa horária em um preço de compra de hardware.
Inclui trabalho de engenharia, termos de uso comprometido, armazenamento, movimentação de dados e o custo de manter uma opção de saída. Estabeleça se as estruturas pretendidas e as implementações de modelo são suportadas. Verifique o que acontece quando a demanda excede a capacidade reservada ou fica abaixo dela.
Um sistema próprio tem suas próprias restrições: capital investido em equipamentos, trabalho de instalação e uma quantidade finita de capacidade. Uma comparação justa afirma explicitamente estas diferenças, em vez de assumir que a propriedade ou o aluguer são automaticamente económicos.
Divida a carga de trabalho antes de escolher a plataforma
Uma empresa não precisa treinar e servir em infraestrutura idêntica. É necessário um processo confiável para mover modelos entre ambientes e verificar se a qualidade e o desempenho permanecem aceitáveis.
A resposta prática à abordagem de duas plataformas de Google é escrever dois conjuntos de requisitos. Deve-se descrever o desenvolvimento e o treinamento; o outro deve descrever o serviço de produção. Se esses requisitos levarem a diferentes hardwares ou fornecedores, essa pode ser uma escolha deliberada de arquitetura. A questão útil é quanto custa o fluxo de trabalho completo e quão confiável ele é executado.
Fontes e leituras adicionais
Fontes primárias para os desenvolvimentos relatados e contexto técnico. As análises e conclusões são nossas; especificações e documentação vinculadas podem mudar.
- Google: TPU 8t e TPU 8i ↗Publicado em 22 de abril de 2026
Fontes verificadas em 29 de setembro de 2026.