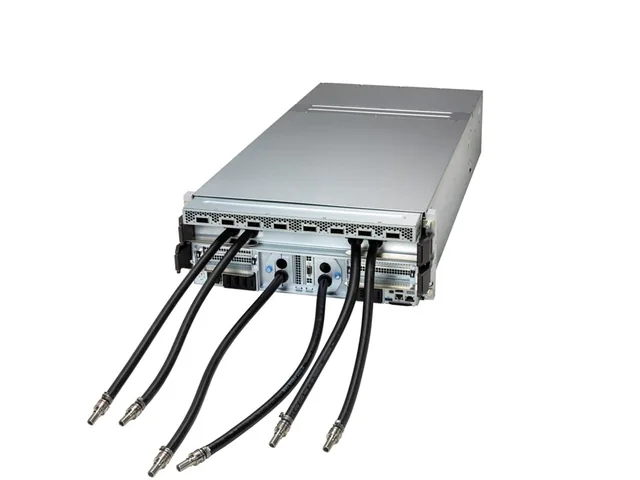
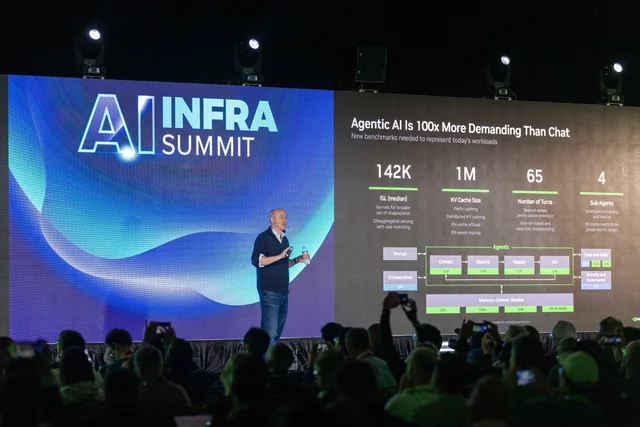
ネットワークはAIコンピュータの一部
光学ネットワークおよびラックスケールシステムは理由から注意を得る。Multi-GPUのパフォーマンスは、データが機械の間でどのように移動するかによって決まります。
システムの問題が目に見える。
NVIDIAの2026年3月のCoherentとのパートナーシップは、より大きなデータセンターアーキテクチャのための光学技術に焦点を当てた。その後のRubinの生産発表には、より広いプラットフォーム内の光学Ethernetネットワークが含まれています。これらの開発は、インフラの議論におけるコンピュータとともに接続性を置いた。 NVIDIAとCoherent:光学ネットワークパートナーシップ NVIDIA:Vera Rubinが完全生産を開始
買い手にとって、その意味は、すべての配布が最新の光学組織を必要とするものではありません。それは、強力なサーバーのコレクションが自動的に一つのよく接続されたシステムのように振る舞うわけではありません。アプリケーションは、どのくらいのコミュニケーションが必要であり、遅延が重要になるかを決定します。
異なるリンクが異なる仕事を持っている
GPUサーバー内のコミュニケーションとサーバー間のコミュニケーションは、トポロジーの分離的な部分です。それゆえに、ストレージへの道と通常の管理ネットワークです。その順序の一部の速いリンクは、別の場所でボトルネックを取り除くことはできません。
データストリームをマッピングすることから始まります. 各サーバーは独立したリクエストで動作しますか? モデルは複数のデバイスやノードを広げますか? チェックポイントやデータセットが頻繁に移動する必要がありますか? これらの質問は、ネットワークが作業負荷に中心であるか、あるいは主にサポート要件であるかどうかを確認するのに役立ちます。
独立した結論の複製は、厳密に組み合わせたトレーニングの仕事とは異なります. 証拠なしで最初のための複雑な組織を購入することは、予算を無駄にすることができます; 後者の未定化は、高価な加速器を待つことができる。
港は完全な接続ではない。
材料のネットワーク計算には、アダプター、スイッチ、光学またはケーブル、適切な物理的な長さとそれらを操作するために必要なサポートが含まれます。
提案された構成全体をチェックします. サーバーの引用に含まれるコンポーネントを特定し、より広いクラスターの購入に属するコンポーネントを特定します. 問題がサーバーとスイッチを越えるときに構成とエラーの診断に責任を負う者を特定します。
また、観測性を考慮してください. 通路結果は、混合作業負荷の下でのみ現れるリトランミッション、コンゲスト、または不均衡なパフォーマンスを隠すことができます. 作業チームは、インストール後、これらの条件を特定する方法が必要です。
計画されたトポロジーを通じてアプリケーションをテストする
単一サーバーのバランスマークは、複数のサーバーのスケールを設定することはできません. 関連するノードの計算で予定された作業負荷を測定し、コミュニケーション設定を記録します. 完成した作業を完全な構成のコストとパワーと比較します。
光学統合は大きなインフラのための重要な方向ですが、それはトポロジー計画の必要性を排除するものではありません。多くの購入者にとって、即時改善はより一般的です:完全なネットワーク仕様、適切なケーブル、および適切なアプリケーションに依存するすべてのリンクを含む承認計画。
情報源&続きを読む
分析と結論は私たち自身であり、関連する規格と文書化は変化する可能性があります。
- NVIDIAとCoherent:光学ネットワークパートナーシップ投稿者: 2026年3月2日
- NVIDIA:Vera Rubinが完全生産を開始投稿者: 2026年5月31日
情報源は2026年9月29日に確認されました。