La rete fa parte del computer AI
Le reti ottiche e i sistemi su scala rack ricevono attenzione per un motivo. Le prestazioni multi-GPU dipendono da come i dati si spostano tra le macchine.
Un problema di sistema diventa visibile
La partnership di marzo 2026 di NVIDIA con Coherent si è concentrata sulla tecnologia ottica per architetture di data center più grandi. Il successivo annuncio di produzione di Rubin include la rete ottica Ethernet all'interno della piattaforma più ampia. Questi sviluppi mettono la connettività accanto all’informatica nella discussione sull’infrastruttura. NVIDIA e Coherent: partnership per reti ottiche ↗ NVIDIA: Vera Rubin entra in piena produzione ↗
Per un acquirente, l'implicazione non è che ogni implementazione necessiti del tessuto ottico più recente. Il fatto è che un insieme di server potenti non si comporta automaticamente come un sistema ben connesso. L'applicazione determina quanta comunicazione è necessaria e dove saranno importanti i ritardi.
Collegamenti diversi hanno compiti diversi
La comunicazione all'interno di un server GPU e la comunicazione tra server sono parti separate della topologia. Lo stesso vale per i percorsi di stoccaggio e di gestione ordinaria della rete. Un collegamento veloce in una parte di tale accordo non può eliminare un collo di bottiglia altrove.
Inizia mappando il flusso di dati. Ogni server funziona su richieste indipendenti? Un modello si estende su più dispositivi o nodi? I checkpoint o i set di dati devono spostarsi frequentemente? Queste domande aiutano a stabilire se il networking è centrale per il carico di lavoro o principalmente un requisito di supporto.
Le repliche di inferenza indipendenti possono scalare in modo diverso rispetto a un lavoro di formazione strettamente associato. Acquistare un tessuto elaborato per il primo senza prove può sprecare il budget; sottospecificare quest'ultimo può lasciare in attesa costosi acceleratori.
Una porta non è una connessione completa
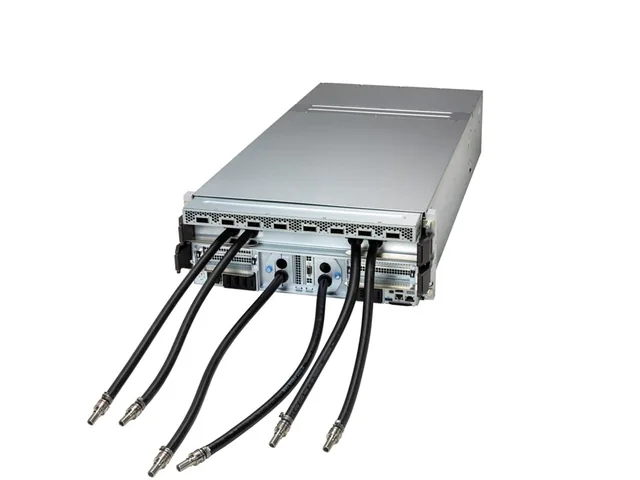
Una distinta base della rete comprende adattatori, interruttori, ottiche o cavi, lunghezze fisiche adeguate e il supporto necessario per il loro funzionamento. La compatibilità e la topologia contano insieme alla velocità principale.
Controllare la configurazione proposta nel suo insieme. Identificare quali componenti sono inclusi nel preventivo del server e quali appartengono all'acquisto di un cluster più ampio. Stabilire chi è responsabile della configurazione e della diagnosi dei guasti quando il problema riguarda un server e uno switch.
Considera anche l'osservabilità. Un risultato di throughput può nascondere ritrasmissioni, congestioni o prestazioni irregolari che appaiono solo in caso di carico di lavoro misto. Il team operativo ha bisogno di un modo per identificare tali condizioni dopo l'installazione.
Testare l'applicazione attraverso la topologia pianificata
Un benchmark a server singolo non può stabilire la scalabilità multi-server. Misurare il carico di lavoro previsto nei conteggi dei nodi pertinenti e registrare le impostazioni di comunicazione. Confronta il lavoro completato con il costo e la potenza della configurazione completa.
L'integrazione ottica è una direzione importante per le grandi infrastrutture, ma non elimina la necessità di pianificare la topologia. Per molti acquirenti, il miglioramento immediato è più ordinario: specifiche di rete complete, cavi adeguati e un piano di validazione che includa tutti i collegamenti da cui dipende l'applicazione.
Fonti e approfondimenti
Fonti primarie per gli sviluppi riportati e il contesto tecnico. L'analisi e le conclusioni sono nostre; le specifiche e la documentazione collegate possono cambiare.
- NVIDIA e Coherent: partnership per reti ottiche ↗Pubblicato il 2 marzo 2026
- NVIDIA: Vera Rubin entra in piena produzione ↗Pubblicato il 31 maggio 2026
Fonti controllate il 29 settembre 2026.